Welke luistergedragsignalen trackt Spotify?
De sterkste inputs komen van hoe luisteraars met je muziek interageren.
| Signaal | Impact | Waarom het ertoe doet |
|---|---|---|
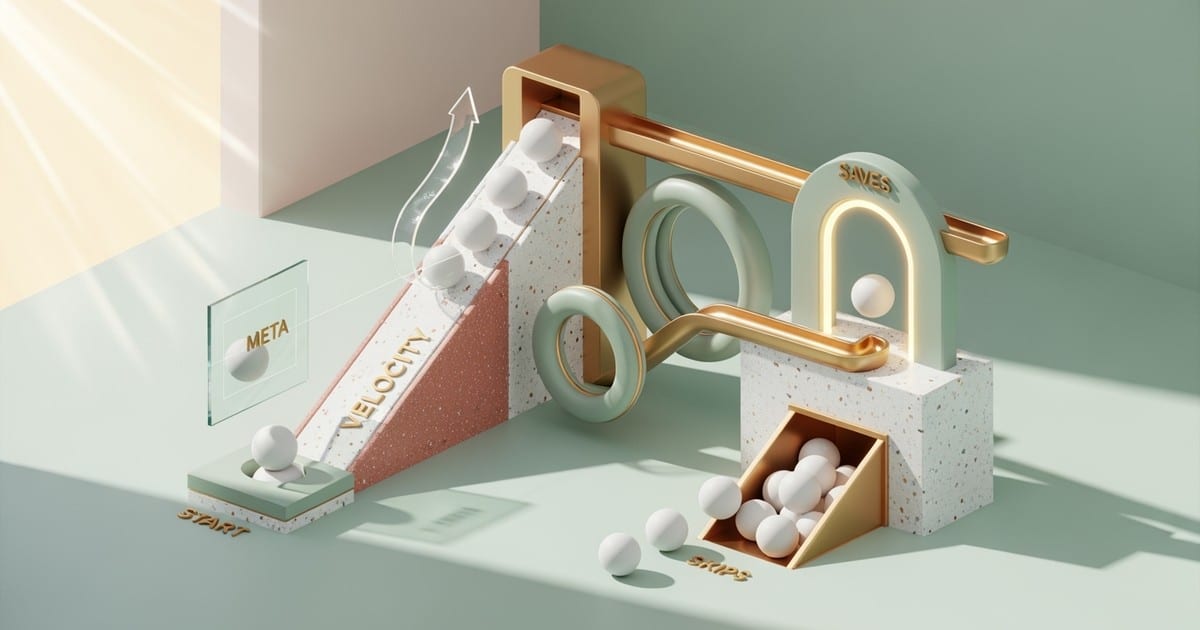
| Saves | Zeer hoog | Direct signaal dat een luisteraar de track opnieuw wil horen |
| Afspeellijstadds | Zeer hoog | Toont dat de track in een luistercontext past |
| Volledige luisteringen | Hoog | Bevestigt dat het nummer aandacht vasthield |
| Herhaalde luisteringen | Hoog | Versterkt voorkeur over tijd |
| Volgingen | Medium | Garandeert dat toekomstige releases die luisteraar bereiken |
| Skips voor 30s | Negatief | Indiceert een mismatch tussen luisteraar en track |
Note Spotify publiceert geen exacte drempels voor deze signalen. Focus op het verbeteren van je ratios relatief aan je eigen baseline, niet het najagen van mythische "algoritmepercentages."
Hoe beïnvloedt collaborative filtering je bereik?
Wanneer luisteraars die van vergelijkbare artiesten houden je track saven of herhalen, leert het algoritme dat je in dezelfde smaakcluster hoort. Dit is collaborative filtering: de "luisteraars die van X hielden hielden ook van Y"-logica.
Dit beïnvloedt in welke Discover Weekly-afspeellijsten je muziek verschijnt en hoe vaak je surfacet in Radio-sessies geseed vanuit vergelijkbare artiesten. Je kunt collaborative filtering niet direct controleren, maar je kunt het beïnvloeden door luisteraars te targeten die al van muziek vergelijkbaar met de jouwe houden.
Hoe dragen audiokenmerken bij aan het algoritme?
Spotify analyseert elke track's tempo, toonsoort, luidheid, timbre, energie en structuur. Deze audio-embeddings helpen het algoritme sonische buren vinden, bijzonder belangrijk voor nieuwe releases met beperkte gedragsdata.
Als je track klinkt als artiesten in een specifieke cluster, zal het algoritme het testen tegen luisteraars die van die cluster houden. Accurate genre- en stemmingmetadata helpt dit proces correct werken.
Hoe beïnvloeden metadata en tagging het algoritme?
Je distributeurmetadata beïnvloedt direct waar Spotify je muziek categoriseert:
- Genretags bepalen welke redactionele en algoritmische buckets je binnenkomt
- Stemmingdescriptors beïnvloeden plaatsing in stemming-gebaseerde afspeellijsten
- Artiestcredits (featuring, remixer) beïnvloeden wiens volgers je release zien
- Releasetype (single, EP, album) beïnvloedt hoe tracks geprioriteerd worden
Inaccurate metadata leidt tot mismatchede aanbevelingen. Als je een ambient-track tagt als "pop," wordt het getest tegen popluisteraars die waarschijnlijk zullen skippen.
Hoe beïnvloedt releasetiming algoritmische prestaties?
Wanneer je uitbrengt beïnvloedt initiële distributie:
Vrijdagreleases aligneren met de mondiale chartverversing en Release Radar-updates. De meeste industrie-releases droppen op vrijdag, wat hogere competitie betekent maar ook wanneer luisteraars nieuwe muziek verwachten.
7+ dagen vroeg pitchen zorgt dat je track geschikt is voor Release Radar-inclusie bij je volgers. Dit venster missen betekent dat je eerste week algoritmische distributie naar je bestaande publiek mist.
Snelheid in week één doet ertoe. Het algoritme trackt veranderingssnelheid. Een geconcentreerde burst van engagement in de eerste 48–72 uur creëert een sterker signaal dan dezelfde engagement verspreid over weken.
Wat je controleert versus wat je observeert
| Factor | Je controleniveau |
|---|---|
| Metadata-accuratesse | Volledig |
| Pitchtiming | Volledig |
| Eerste 30 seconden-kwaliteit | Volledig |
| Doelpubliekselectie | Hoog |
| Save rate | Indirect (beïnvloed door CTA's en publiekskwaliteit) |
| Collaborative-filtering-plaatsing | Indirect (beïnvloed door wie engageert) |
| Redactionele-afspeellijst-inclusie | Geen (mens-gecureerd) |
Focus je inspanning op de factoren die je kunt beïnvloeden. Accurate metadata, juiste pitchtiming, sterke intro's en gerichte publiekbouw compounderen allemaal in betere algoritmische uitkomsten.
Wat zijn de veelvoorkomende misconcepties over het Spotify-algoritme?
"Meer streams betekent betere algoritmesteun." Onwaar. Streams zonder saves of met hoge skips beschadigen actief je algoritmische profiel.
"Tijdstip van de dag beïnvloedt het algoritme." Geen bewijs ondersteunt dit. Wat ertoe doet is engagementsnelheid, niet de klok.
"VS/VK-streams tellen meer." Spotify heeft geen geografische waardering gepubliceerd. Plan rond publieksgedrag, niet ongeverifieerde multipliers.
Hoeveel beweegt elk signaal de naald?
Spotify publiceert geen exacte gewichten, maar geaggregeerde campagnedata van Dynamoi-klanten onthult consistente directionele patronen:
| Signaalverandering | Waargenomen effect op algoritmisch bereik |
|---|---|
| Save rate 10% naar 20% | 2–3x toename in Radio- en Discover Weekly-plaatsingen binnen 14 dagen |
| Skiprate daalt onder 25% | Merkbare expansie voorbij volgersbasis binnen 7 dagen |
| 500+ saves in eerste 48 uur | Consistente trigger voor Release Radar-expansie naar niet-volgers |
| Afspeellijstadds boven 5% van luisteraars | Track begint te verschijnen in Autoplay-rotaties voor vergelijkbare artiesten |
| Herhaalde-luistering-rate boven 15% | Sterk signaal voor Daily Mix-inclusie en langetermijn-catalogus-heroppervlakking |
Dit zijn directionele observaties, geen garanties. Elk signaal interageert met de anderen en met competitieve context. Een 20% save rate in een rustige releaseweek zal sneller expansie triggeren dan dezelfde rate tijdens een major-label-release-druk.
Gebruik huidige Spotify-royaltydata om de omzetkant te modelleren. Save rate verbeteren van 10% naar 20% op een track die 50.000 initiële luisteraars bereikt kan het verschil betekenen tussen 75.000 totale streams en 200.000+ streams over het eerste jaar van de track.